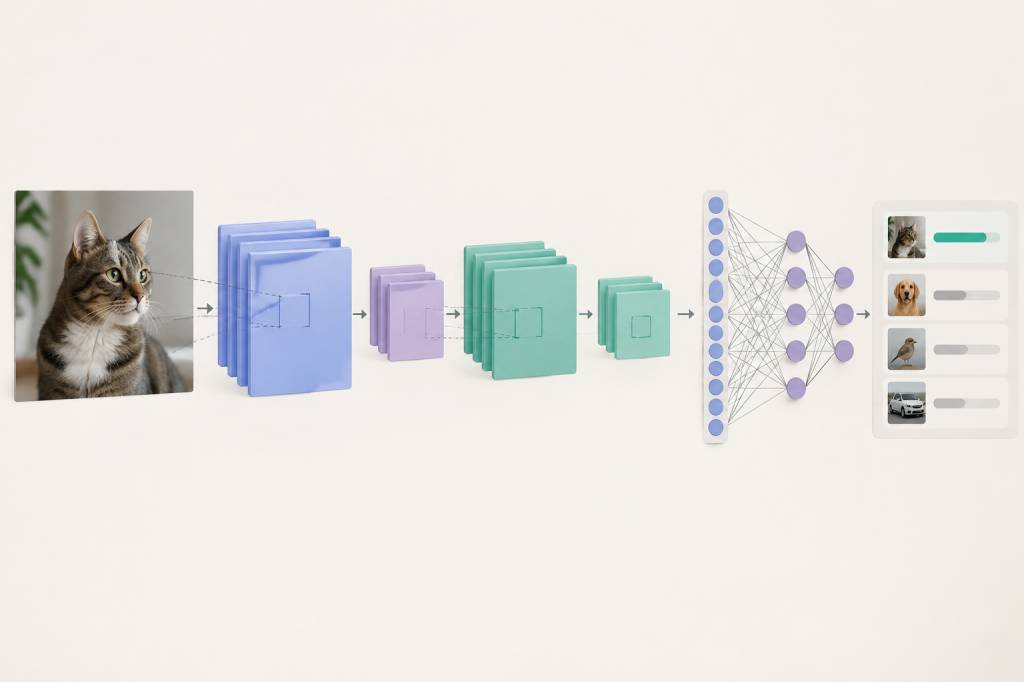
Convolutional neural network et deep learning : comprendre les réseaux de neurones convolutifs
Quand vous reconnaissez un chat sur une photo, vous ne commencez pas par mesurer chaque pixel. Vous repérez plutôt des formes, des contours, des oreilles, puis vous assemblez ces indices pour identifier l’animal. Un réseau de neurones convolutif, ou CNN pour Convolutional Neural Network, suit une logique comparable. Il apprend à repérer des caractéristiques visuelles simples, puis à les combiner pour reconnaître des objets ou des motifs plus complexes.
Ces réseaux sont au cœur de nombreuses applications de deep learning : reconnaissance faciale, analyse d’images médicales, lecture automatique de documents ou encore conduite assistée. Mais que signifie exactement « convolutionnel » ? Et comment un ordinateur peut-il apprendre à distinguer un chat d’un grille-pain ? Prenons le temps de dérouler les étapes, sans transformer cet article en cours de mathématiques indigeste.
Deep learning : des réseaux de neurones qui apprennent à plusieurs niveaux
Le deep learning, ou apprentissage profond, est une branche de l’intelligence artificielle. Il s’appuie sur des réseaux de neurones artificiels composés de plusieurs couches de calcul. Ces couches transforment progressivement les données d’entrée pour produire un résultat : une catégorie, une prévision ou une décision.
Le mot « profond » fait référence à la succession de couches, et non à une réflexion particulièrement philosophique de la machine. Chaque couche apprend à détecter certains éléments utiles. Dans une image, les premières couches peuvent repérer des lignes ou des contrastes. Les suivantes combinent ces éléments pour reconnaître des formes, puis des objets.
On peut comparer ce processus à la construction d’un tableau de bord dans Excel. Une cellule isolée ne raconte pas grand-chose. Mais en regroupant les données, en calculant des indicateurs et en les mettant en perspective, on obtient une information beaucoup plus exploitable. Un réseau de neurones procède lui aussi par transformations successives, même si ses « cellules » sont des unités de calcul et non des cases avec une jolie mise en forme conditionnelle.
Pourquoi les images demandent une approche particulière
Une image numérique est constituée de pixels. Une image en niveaux de gris associe généralement une valeur à chaque pixel, tandis qu’une image couleur comporte souvent trois composantes : rouge, vert et bleu. Une photographie de 1 000 par 1 000 pixels contient donc déjà un million de positions, sans compter les canaux de couleur.
Une méthode simple consisterait à envoyer toutes ces valeurs à un réseau classique. Le problème ? Le nombre de paramètres peut vite devenir énorme. Il faudrait également que le modèle comprenne que deux pixels voisins ont souvent une relation importante, par exemple parce qu’ils dessinent ensemble le bord d’un objet.
Les CNN sont conçus pour exploiter la structure spatiale des images. Ils analysent des zones locales et réutilisent les mêmes opérations à différents endroits. Cette approche réduit le nombre de paramètres à apprendre et aide le réseau à repérer un motif, qu’il se trouve au centre ou dans un coin de l’image.
La convolution, ou l’art de balayer une image avec un filtre
Le cœur d’un CNN est l’opération de convolution. Imaginez une petite grille, appelée filtre ou noyau, qui se déplace sur l’image. À chaque position, elle combine les valeurs des pixels voisins pour produire un nouveau résultat. Le réseau répète cette opération sur toute l’image et obtient une carte de caractéristiques.
Un filtre peut apprendre à repérer un bord vertical, une zone claire ou une texture particulière. Au départ, ses valeurs sont généralement initialisées de manière à permettre l’apprentissage. Le modèle les ajuste ensuite en fonction des exemples et des erreurs commises. Il ne reçoit donc pas nécessairement une liste de filtres préparés à la main : il apprend les caractéristiques les plus utiles à sa tâche.
Voici une analogie façon Excel : imaginez une petite formule que vous appliquez à chaque bloc de cellules d’un tableau. Elle vérifie, par exemple, si les valeurs changent brusquement d’une colonne à l’autre. Un filtre de convolution fait quelque chose de comparable, mais sur des groupes de pixels et avec des paramètres que le modèle optimise pendant l’entraînement.
La convolution est souvent suivie d’une fonction d’activation, comme ReLU, qui ajoute une non-linéarité au réseau. Sans entrer dans les détails, cette étape permet au modèle d’apprendre des relations plus variées qu’une simple combinaison linéaire de valeurs.
Des contours aux objets : les couches apprennent par étapes
Un CNN contient généralement plusieurs couches de convolution. Les premières détectent des caractéristiques simples : lignes, angles, contrastes ou petites textures. Les couches suivantes combinent ces éléments pour reconnaître des motifs plus élaborés, comme un œil, une roue ou une lettre.
Dans un système de reconnaissance d’images, les couches profondes peuvent finir par représenter des objets ou des parties d’objets. Le modèle n’a pas besoin qu’on lui explique explicitement ce qu’est une oreille de chat. Il peut apprendre, à partir d’exemples annotés, quelles combinaisons de motifs sont associées à la catégorie « chat ».
Cette organisation est parfois présentée comme une hiérarchie : des détails simples au début, des concepts plus complexes ensuite. C’est une bonne façon de se représenter le mécanisme, même si les calculs réels sont plus nuancés et que les caractéristiques apprises ne correspondent pas toujours à des objets clairement identifiables par un humain.
Le pooling : réduire la taille sans tout perdre
Après certaines convolutions, les CNN utilisent parfois une opération appelée pooling. Son rôle est de réduire la taille des cartes de caractéristiques. Par exemple, une opération de maximum pooling conserve la valeur la plus élevée dans de petites zones.
Pourquoi réduire l’information ? Cela diminue la quantité de calculs et rend le modèle un peu moins sensible à la position exacte d’un motif. Si un œil se déplace de quelques pixels sur une photo, le réseau peut tout de même reconnaître un visage. En revanche, un pooling trop agressif risque de faire disparaître des détails importants, notamment dans des images très petites ou des tâches exigeant une localisation précise.
Tous les CNN n’utilisent pas le pooling de la même manière. Certaines architectures réduisent la taille des cartes en modifiant directement le pas de déplacement des filtres. Comme souvent en intelligence artificielle, il n’existe pas une seule recette universelle : le choix dépend du problème traité.
Comment un CNN apprend-il à faire la bonne prédiction ?
L’entraînement commence avec un jeu d’exemples. Pour chaque image, le modèle reçoit généralement une étiquette, comme « chien », « vélo » ou « pomme ». Il produit une prédiction, qui est comparée à l’étiquette attendue à l’aide d’une fonction de perte. Cette fonction mesure l’écart entre la réponse du réseau et la bonne réponse.
Le réseau ajuste ensuite ses paramètres afin de réduire cette erreur. Ce processus repose notamment sur la rétropropagation du gradient : l’information sur l’erreur est renvoyée à travers les couches pour déterminer comment modifier les paramètres. L’opération est répétée sur de nombreux exemples, souvent pendant plusieurs cycles appelés époques.
La qualité des données est essentielle. Si les images d’entraînement montrent surtout des chats pris en intérieur, le modèle risque d’être moins performant devant un chat photographié dans un jardin, sous la pluie ou avec une coupe de cheveux très discutable. Il faut donc disposer de données suffisamment variées et correctement étiquetées.
On sépare habituellement les données en ensembles d’entraînement, de validation et de test. Les premières servent à apprendre, les secondes à ajuster les choix du modèle, et les dernières à évaluer ses performances sur des exemples qu’il n’a pas utilisés pendant l’apprentissage. Tester un modèle uniquement sur ses exercices préférés ne serait pas très honnête, même pour une intelligence artificielle.
À quoi servent les réseaux de neurones convolutifs ?
La reconnaissance d’images est l’usage le plus connu des CNN, mais leurs applications vont bien au-delà. Ils peuvent notamment :
-
Classer des images : identifier une espèce végétale, un type de produit ou un panneau de signalisation.
-
Détecter des objets : localiser plusieurs éléments dans une image, par exemple des véhicules dans une scène de circulation.
-
Analyser des images médicales : aider à repérer certaines anomalies sur des radiographies ou des scanners, avec validation par des professionnels de santé.
-
Lire des documents : reconnaître des caractères manuscrits ou détecter des zones de texte sur un formulaire numérisé.
-
Traiter des vidéos ou des signaux : analyser des images successives ou certains types de données organisées en grilles.
Un exemple très concret : une entreprise qui reçoit des milliers de photos de produits peut utiliser un CNN pour les classer automatiquement par catégorie. Les équipes gagnent du temps sur le tri, mais doivent toujours vérifier les erreurs et gérer les cas particuliers. L’automatisation accélère le travail ; elle ne transforme pas chaque prédiction en vérité absolue.
Les forces et les limites des CNN
Les CNN sont performants parce qu’ils tiennent compte de la proximité entre les pixels et réutilisent leurs filtres sur différentes zones. Ils peuvent apprendre des caractéristiques difficiles à définir manuellement et s’adaptent à une grande variété de tâches visuelles.
En contrepartie, ils ont souvent besoin de nombreux exemples et de ressources de calcul importantes, surtout lorsqu’on entraîne un modèle de grande taille depuis zéro. Ils peuvent aussi être sensibles aux biais des données. Si certaines catégories sont sous-représentées, la qualité des prédictions risque d’être inégale.
Autre point important : une excellente performance sur un jeu de test ne garantit pas un comportement fiable dans toutes les situations réelles. Une image floue, une lumière inhabituelle ou un objet partiellement masqué peuvent perturber le modèle. Pour une application à risque, il faut prévoir des contrôles, surveiller les résultats et conserver une intervention humaine adaptée.
Enfin, les CNN ne « comprennent » pas une image comme une personne. Ils apprennent des régularités statistiques à partir des données. Cette distinction est utile : elle évite de confondre une prédiction impressionnante avec une compréhension générale du monde.
Faut-il entraîner son propre réseau de neurones ?
Pas nécessairement. Entraîner un CNN complet demande des données, du temps et du matériel adapté. Dans de nombreux projets, on part plutôt d’un modèle déjà entraîné sur un grand ensemble d’images, puis on l’adapte à une tâche précise. Cette technique, appelée apprentissage par transfert, permet de réutiliser des caractéristiques déjà apprises, comme les contours et les textures.
Pour découvrir le fonctionnement des CNN, des bibliothèques comme TensorFlow et PyTorch proposent des outils et des modèles prêts à l’emploi. Les notebooks interactifs sont également utiles pour tester une architecture et visualiser certaines étapes. Et si votre objectif est simplement de classer une liste ou de suivre des résultats, Excel reste souvent l’outil le plus direct : pas besoin de déployer un réseau convolutif pour savoir quel produit affiche le meilleur chiffre d’affaires.
Les réseaux convolutifs montrent surtout comment une idée simple — appliquer les mêmes filtres à des zones locales — peut devenir très puissante lorsqu’elle est combinée à plusieurs couches et à un apprentissage sur des exemples. Une image qui semble évidente à nos yeux représente pour une machine une vaste grille de nombres. Le CNN lui apprend à y repérer des indices, à les assembler et à produire une prédiction. C’est cette progression, du pixel à la catégorie, qui rend le deep learning à la fois fascinant et très concret.