Apprentissage supervisé et non supervisé : différences et exemples concrets
Deux façons d’apprendre à une machine
Imaginez un grand tableau Excel rempli de lignes de commandes : date, montant, type de produit, région et statut de paiement. Vous aimeriez savoir quelles factures risquent d’être réglées en retard. Une machine peut vous aider à répondre à cette question, mais elle a besoin d’apprendre à partir de vos données.
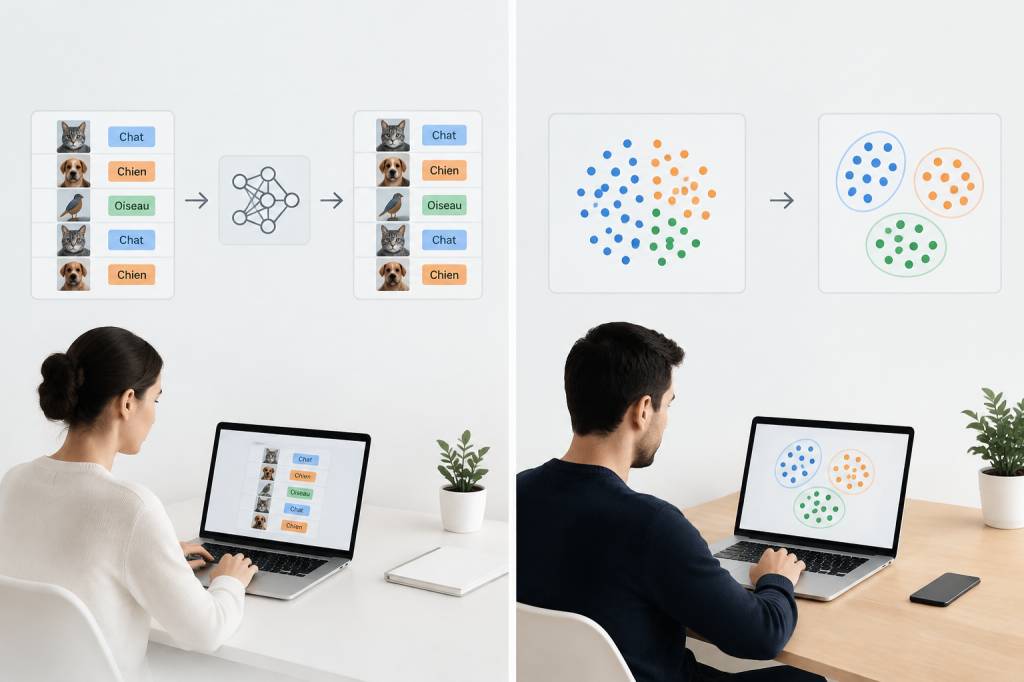
Il existe deux grandes approches : l’apprentissage supervisé et l’apprentissage non supervisé. Dans le premier cas, on fournit à la machine des exemples accompagnés de la réponse attendue. Dans le second, on lui donne des données sans réponse et on la laisse chercher des regroupements ou des structures. La différence paraît simple, mais elle change tout dans la façon de préparer les données et d’interpréter les résultats.
Pas besoin d’être chercheur en intelligence artificielle pour comprendre ces méthodes. Quelques exemples concrets, et vous verrez comment les reconnaître — voire comment les explorer à partir de données que vous connaissez déjà.
L’apprentissage supervisé : apprendre avec les réponses
En apprentissage supervisé, on entraîne un modèle à partir d’exemples pour lesquels la réponse est connue. Dans un tableau, les données utilisées pour décrire chaque exemple constituent les caractéristiques. La réponse que le modèle doit apprendre à prédire est appelée la cible.
Reprenons les factures. Pour chaque ligne, vous pouvez avoir le montant, le délai de paiement habituel du client, la région et le type de prestation. Si vous connaissez aussi le statut final — « réglée à temps » ou « en retard » — cette information peut servir de cible. Le modèle étudie les factures passées et apprend à repérer les situations associées aux retards.
Une fois entraîné, il peut estimer le statut probable d’une nouvelle facture. Il ne lit pas l’avenir et ne garantit pas que son avis sera juste : il formule une prédiction à partir des exemples qu’on lui a fournis.
Pour que l’apprentissage fonctionne, il faut donc disposer de données déjà renseignées avec les bonnes réponses. On les appelle des données étiquetées. Si les anciens statuts de paiement sont incomplets ou incorrects, le modèle risque d’apprendre à partir d’informations trompeuses. C’est le principe du « mauvaises données en entrée, mauvais résultats en sortie » — sans magie, même avec un ordinateur très motivé.
Deux types de problèmes supervisés
L’apprentissage supervisé sert principalement à résoudre deux types de problèmes : la classification et la régression.
-
La classification consiste à choisir une catégorie. Une facture sera, par exemple, classée « en retard » ou « à l’heure ». De la même façon, un message peut être identifié comme indésirable ou légitime.
-
La régression consiste à estimer une valeur numérique. On peut chercher à prévoir le chiffre d’affaires du mois prochain, la durée d’une livraison ou le prix probable d’un logement.
Dans les deux cas, le modèle apprend à partir d’exemples passés dont la cible est connue. La différence tient à la nature de cette cible : une catégorie pour la classification, un nombre pour la régression.
Un point important : les données disponibles au moment de faire une prédiction doivent aussi être disponibles au moment où l’on entraîne le modèle. Si votre tableau contient une colonne ajoutée après le règlement d’une facture, cette colonne ne peut pas servir à prédire son retard à l’avance. Le modèle aurait alors accès à une information qu’il ne pourrait pas connaître dans une situation réelle.
L’apprentissage non supervisé : chercher des motifs sans réponse fournie
En apprentissage non supervisé, on donne au modèle des données sans lui indiquer la réponse attendue. Il doit repérer lui-même des ressemblances, des groupes ou des comportements inhabituels.
Reprenons votre tableau de commandes. Cette fois, vous n’avez pas de colonne indiquant le type de client. Vous disposez seulement de données comme le montant moyen, la fréquence d’achat et les catégories de produits commandées. Un modèle peut repérer plusieurs profils : des clients qui achètent souvent de petits montants, d’autres qui commandent rarement mais beaucoup, et d’autres encore qui se concentrent sur une gamme précise.
Cette méthode ne sait pas d’avance que le premier groupe devrait s’appeler « clients réguliers » ou que le second correspond à des « acheteurs occasionnels ». Elle repère des groupes selon les informations disponibles. C’est à vous d’examiner les résultats et de décider s’ils sont utiles et comment les décrire.
Autrement dit, le modèle propose une organisation ; il ne lui donne pas automatiquement une signification métier. C’est souvent là que l’expertise humaine fait la différence. Un regroupement peut être mathématiquement cohérent, mais peu utile pour prendre une décision.
Les usages courants de l’apprentissage non supervisé
Le regroupement est l’usage le plus connu de l’apprentissage non supervisé. Il consiste à rassembler des observations qui se ressemblent. On peut ainsi segmenter des clients, repérer des familles de produits ou classer des interventions selon leurs caractéristiques.
Une autre application est la détection d’anomalies. Le modèle observe le comportement habituel des données et signale les éléments qui s’en éloignent fortement. Dans un tableau de dépenses, il pourrait attirer l’attention sur une transaction d’un montant inhabituel ou réalisée dans des circonstances rarement observées.
Une anomalie n’est pas nécessairement une erreur ou une fraude. Elle peut correspondre à une dépense parfaitement justifiée, mais suffisamment rare pour mériter une vérification. Considérez le signal comme une piste à examiner, pas comme un verdict.
L’apprentissage non supervisé peut aussi aider à simplifier des jeux de données volumineux. Certaines méthodes résument les nombreuses caractéristiques d’un tableau en quelques dimensions plus faciles à explorer. C’est pratique pour visualiser des données complexes, même si l’interprétation demande un peu de prudence.
Les différences essentielles en un coup d’œil
-
Les réponses sont-elles connues ? En supervisé, oui : chaque exemple d’entraînement est associé à une cible. En non supervisé, non : le modèle cherche des structures sans réponse préétablie.
-
Que cherche-t-on ? Le supervisé sert à prédire une catégorie ou une valeur. Le non supervisé sert surtout à découvrir des groupes, des ressemblances ou des anomalies.
-
Quel est le rôle de l’humain ? En supervisé, il faut notamment préparer des exemples fiables et vérifier les prédictions. En non supervisé, il faut aussi interpréter les groupes ou les signaux trouvés.
-
Comment juge-t-on le résultat ? En supervisé, on peut comparer les prédictions aux réponses réellement observées. En non supervisé, il n’y a pas toujours de réponse de référence : l’utilité des regroupements dépend souvent du contexte et de leur interprétation.
Une même question métier peut même se prêter aux deux approches. Pour comprendre vos clients, vous pouvez d’abord utiliser une méthode non supervisée afin de découvrir des profils. Ensuite, si vous possédez des données historiques sur les achats futurs, vous pouvez entraîner un modèle supervisé pour prédire quels clients sont susceptibles de commander un produit donné.
Un exemple concret avec un tableau de ventes
Supposons que vous ayez plusieurs années de données de ventes : date, produit, prix, région, quantité et identité du client. Que pouvez-vous en faire ? Tout dépend de la question que vous souhaitez poser.
Si vous voulez prévoir la quantité qui sera vendue le mois prochain, vous cherchez une valeur numérique : c’est un problème de régression supervisée, à condition de disposer de résultats historiques utilisables pour l’entraînement. Si vous voulez prédire si un client achètera à nouveau dans les trente jours, il s’agit plutôt d’une classification supervisée : la cible peut être « oui » ou « non ».
En revanche, si vous ne savez pas encore quels profils de clients existent, vous pouvez chercher des groupes à partir de la fréquence des commandes, du panier moyen et des familles de produits achetées. C’est une approche non supervisée. Elle peut vous aider à formuler de nouvelles questions, par exemple : « Les clients qui achètent ces articles réagissent-ils à la même offre ? »
Avant de lancer une analyse, commencez donc par écrire votre question en une phrase. Voulez-vous prédire un résultat connu dans vos archives, ou découvrir des structures que vous ne connaissez pas encore ? Cette distinction vous orientera vers la bonne approche.
Peut-on commencer avec Excel ?
Excel n’est pas, à lui seul, un environnement complet pour entraîner tous les modèles d’apprentissage automatique. En revanche, il est très utile pour préparer, comprendre et vérifier les données qui serviront à une analyse. Et cette étape compte énormément : un modèle sophistiqué ne compensera pas un tableau mal structuré.
Commencez par organiser vos données : une ligne par observation, une colonne par information, des en-têtes clairs et des valeurs cohérentes. Évitez les cellules fusionnées dans la zone de données, les lignes de sous-totaux mélangées aux enregistrements et les dates saisies sous plusieurs formats. Vérifiez aussi les doublons, les valeurs manquantes et les erreurs de saisie.
Si vous préparez un apprentissage supervisé, repérez la colonne cible et assurez-vous qu’elle décrit bien le résultat que vous voulez prédire. Dans un tableau de retards de paiement, par exemple, une valeur vide ne doit pas être confondue avec « paiement à l’heure ». Vide signifie souvent « information inconnue », ce qui est différent d’une réponse.
Pour un apprentissage non supervisé, choisissez avec soin les colonnes qui décrivent les observations. Le numéro de facture, par exemple, sert à identifier une ligne, mais ne décrit généralement pas le comportement d’un client. Le transmettre sans réflexion peut brouiller l’analyse. De même, une colonne contenant des montants très élevés peut prendre une place disproportionnée si les données n’ont pas été mises à la même échelle.
Les tableaux croisés dynamiques, les filtres et les graphiques permettent déjà de repérer des tendances et des valeurs surprenantes. Ils ne remplacent pas un modèle d’apprentissage automatique, mais ils constituent un excellent premier contrôle. Une exploration attentive évite parfois de lancer une analyse complexe pour découvrir ensuite qu’une colonne contient « Paris », « paris » et « PARIS » comme trois valeurs distinctes.
Les pièges à éviter
Le premier piège consiste à choisir une méthode avant de définir le besoin. Dire « je veux faire de l’intelligence artificielle » ne précise pas le problème à résoudre. Une meilleure question serait : « Je veux prévoir les factures qui risquent d’être payées en retard » ou « Je veux découvrir des groupes de clients selon leurs achats ».
Le deuxième piège est de croire qu’une prédiction est une certitude. Un modèle supervisé apprend des régularités observées dans ses données d’entraînement. Si les comportements changent, si les données sont incomplètes ou si de nouveaux cas apparaissent, ses résultats peuvent devenir moins fiables. Il faut donc vérifier ses performances sur des exemples qu’il n’a pas utilisés pour apprendre, puis suivre son comportement dans le temps.
Le troisième piège concerne l’interprétation des groupes non supervisés. Deux groupes trouvés par un modèle ne représentent pas forcément deux types de clients naturels et définitifs. Le résultat dépend des variables choisies, de la qualité des données et de la méthode employée. Essayez plusieurs façons de regarder le problème, puis demandez-vous si les groupes obtenus sont compréhensibles et utiles pour agir.
Choisir la bonne approche pour votre projet
Posez-vous d’abord cette question : connaissez-vous déjà la réponse pour une partie des exemples ? Si oui, l’apprentissage supervisé peut vous aider à prédire cette réponse pour de nouveaux cas. Si non, l’apprentissage non supervisé peut vous aider à explorer les données et à faire émerger des profils ou des situations atypiques.
Dans les deux cas, partez d’un besoin concret, préparez des données propres et gardez un regard critique sur les résultats. L’apprentissage supervisé répond à une question dont on connaît déjà les réponses passées. L’apprentissage non supervisé explore un terrain où les catégories ne sont pas encore définies.
Et si vous ne savez pas encore quelle méthode choisir, ce n’est pas un problème : commencez par examiner votre tableau et préciser ce que vous aimeriez apprendre. Comme souvent avec Excel, la bonne formule vient après la bonne question.