
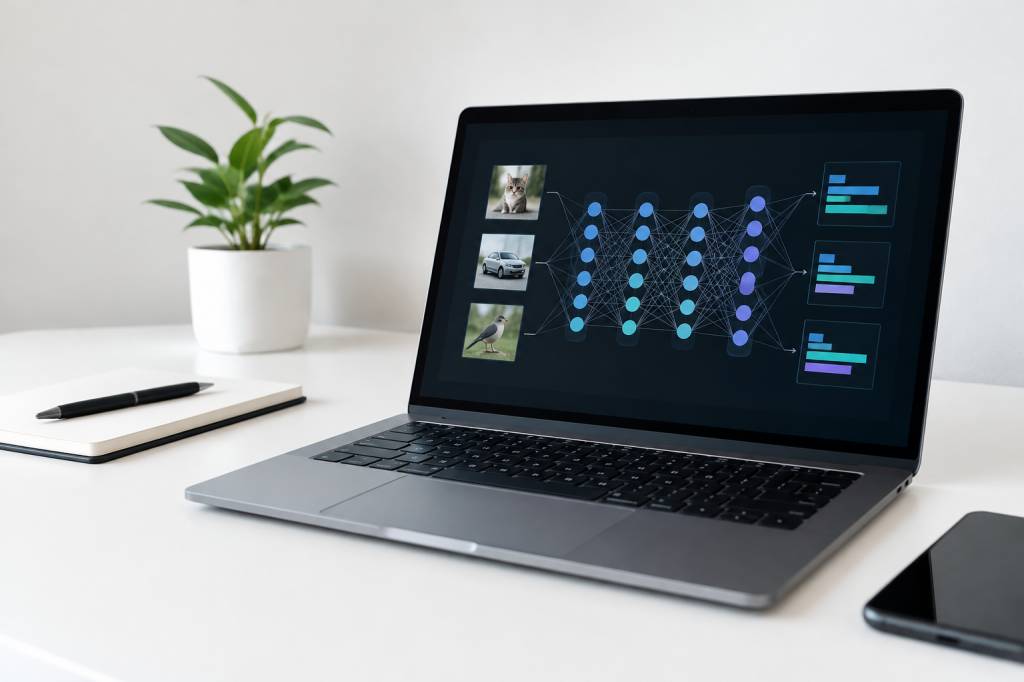
Vous avez peut-être déjà utilisé Excel pour repérer une tendance dans un tableau ou créer un graphique à partir de milliers de lignes. Mais que se passe-t-il quand les données ne sont pas des nombres bien rangés dans des colonnes, mais des images, des sons ou des séquences complexes ? C’est là que les réseaux de neurones convolutifs, ou CNN (pour Convolutional Neural Networks), entrent en scène.
Les CNN sont une famille de modèles d’apprentissage profond particulièrement efficaces pour analyser des images. Ils peuvent reconnaître un défaut sur une pièce industrielle, identifier un chat sur une photo ou extraire des informations d’un document numérisé. Et leur intérêt ne se limite pas aux images : ils peuvent aussi aider à traiter des séries temporelles et certains types de données tabulaires.
Voyons comment ils fonctionnent, à quoi ils servent et ce qu’il faut garder en tête avant de les intégrer à un projet d’analyse de données.
Apprentissage profond : de quoi parle-t-on ?
L’apprentissage profond, ou deep learning, est une branche de l’intelligence artificielle. Il s’appuie sur des réseaux de neurones artificiels composés de plusieurs couches de calcul. Ces couches apprennent progressivement à reconnaître des motifs dans les données.
Pour se représenter l’idée, imaginons un système qui doit reconnaître une photo de chien. Les premières couches peuvent détecter des éléments simples, comme des contours ou des contrastes. Les couches suivantes combinent ces éléments pour repérer des formes plus complexes : une oreille, un museau, puis un animal dans son ensemble.
Le mot « profond » fait référence à la succession de couches, et non à une intelligence mystérieuse cachée dans le modèle. Chaque couche transforme les données et transmet le résultat à la suivante. Le réseau ajuste ensuite ses paramètres en comparant ses prédictions aux bonnes réponses fournies pendant l’entraînement.
Cette approche demande généralement beaucoup d’exemples et de puissance de calcul. En contrepartie, elle peut apprendre elle-même les caractéristiques utiles à la tâche, au lieu de dépendre entièrement de règles définies à la main.
Qu’est-ce qu’un CNN ?
Un réseau de neurones classique peut traiter des données sous forme de nombres, mais analyser une image pixel par pixel pose un problème : une image de taille modeste contient déjà des milliers de valeurs. Il faut aussi tenir compte des relations entre les pixels voisins. Un bord, par exemple, est formé par plusieurs pixels proches les uns des autres.
Le CNN répond à ce défi grâce à des convolutions. Une convolution consiste à faire glisser de petits filtres sur une image afin de détecter des motifs locaux. Un filtre peut apprendre à repérer une ligne verticale, une texture ou un changement de couleur. Ces filtres ne sont généralement pas programmés un par un : le réseau apprend les valeurs les plus utiles pendant son entraînement.
À mesure que les couches s’enchaînent, les motifs deviennent plus élaborés. Dans un système de reconnaissance d’images, le réseau peut passer des lignes et des textures à des formes, puis à des objets. Il ne « voit » pas une image comme un humain, mais il apprend à associer certaines combinaisons de pixels à une catégorie ou à une réponse.
Un CNN courant comporte plusieurs types de couches :
- Les couches de convolution, qui détectent des motifs dans les données.
- Les fonctions d’activation, qui permettent au réseau de modéliser des relations complexes.
- Les couches de réduction, parfois appelées pooling, qui diminuent la taille des représentations et retiennent les informations importantes.
- Les couches de sortie, qui produisent une prédiction : une classe, une valeur ou plusieurs éléments détectés.
Cette architecture est particulièrement adaptée aux images, car elle exploite leur organisation spatiale. Elle évite aussi de traiter chaque pixel comme une information totalement indépendante, ce qui rend l’apprentissage plus efficace que celui d’un réseau entièrement connecté pour de nombreuses tâches visuelles.
Comment un CNN apprend-il ?
Pour entraîner un modèle, on lui fournit des exemples. Dans un problème de classification, chaque image est accompagnée de sa catégorie : « pièce conforme » ou « pièce défectueuse », par exemple. Le CNN propose une prédiction, puis celle-ci est comparée à la réponse attendue.
L’écart entre les deux est mesuré par une fonction de perte. Le modèle modifie ensuite ses paramètres pour réduire cet écart. Ce processus est répété sur de nombreux exemples, souvent plusieurs fois. Une série complète de passages sur les données d’entraînement est appelée une époque.
Un détail essentiel : un modèle qui réussit très bien sur les exemples appris n’est pas forcément performant dans la réalité. Il peut avoir mémorisé les images d’entraînement au lieu d’apprendre des caractéristiques générales. C’est le phénomène de surapprentissage.
Pour vérifier que le modèle sait traiter des cas nouveaux, les données sont généralement séparées en plusieurs groupes :
- Les données d’entraînement, utilisées pour ajuster le modèle.
- Les données de validation, qui aident à choisir les réglages et à surveiller le surapprentissage.
- Les données de test, réservées à l’évaluation finale.
Attention à ne pas faire fuiter des informations entre ces groupes. Si des images presque identiques se retrouvent à la fois dans l’entraînement et dans le test, le score obtenu risque d’être flatteur… sans refléter les performances sur de véritables nouvelles données.
Un exemple concret : automatiser le contrôle qualité
Imaginez une entreprise qui fabrique des composants métalliques. Jusqu’ici, une personne inspecte chaque pièce pour repérer des fissures ou des défauts de surface. Le procédé fonctionne, mais il est répétitif et une inspection visuelle peut varier selon la fatigue ou les conditions d’éclairage.
Un système basé sur un CNN peut analyser les photos des pièces et signaler celles qui méritent une vérification. Pour le mettre en place, l’entreprise collecte des images représentatives, les associe à des étiquettes fiables, puis entraîne et évalue le modèle. Dans un usage réel, le CNN peut retourner une probabilité de défaut ou localiser une zone suspecte.
Le mot important est assister. Dans bien des contextes, le modèle sert de filtre : il accélère le tri et attire l’attention sur les cas à contrôler. Il ne remplace pas automatiquement l’expertise humaine, surtout lorsque le coût d’une erreur est élevé. Une fissure manquée peut coûter cher ; un bon système doit donc être évalué selon les conséquences de ses faux positifs et de ses faux négatifs.
Un tableau Excel peut ensuite compléter le dispositif : nombre de pièces analysées, taux de défauts, résultats par série ou suivi des alertes. Excel ne fait pas tourner le CNN à lui seul, mais il reste très pratique pour explorer les résultats, produire un rapport et partager des indicateurs avec une équipe.
Les applications des CNN en analyse de données
La reconnaissance d’images est l’application la plus connue, mais les CNN couvrent un éventail de besoins bien plus large. Voici quelques exemples utiles à garder en tête :
- Santé : aider à analyser des images médicales, comme des radiographies, avec une validation adaptée aux exigences du domaine.
- Commerce : classer des produits à partir de photos ou repérer des articles dans un catalogue visuel.
- Documents : détecter des zones de texte, des tableaux ou des signatures sur des factures numérisées.
- Agriculture : repérer des maladies sur des feuilles ou suivre l’état de cultures à partir d’images aériennes.
- Industrie : détecter des défauts, surveiller des équipements ou automatiser certaines étapes d’inspection.
- Séries temporelles : apprendre des motifs locaux dans des signaux, par exemple des mesures de capteurs ou des données de consommation.
Pour les séries temporelles, on utilise souvent des convolutions en une dimension. Le principe reste similaire : le filtre se déplace le long d’une séquence plutôt que sur une image. Un modèle peut ainsi apprendre à détecter une anomalie dans un signal de température ou un motif récurrent dans des données de production.
Les CNN peuvent également intervenir dans des systèmes de traitement du langage, notamment pour repérer des motifs dans des séquences de mots ou de caractères. D’autres architectures, comme les Transformers, dominent aujourd’hui de nombreux usages du langage, mais les convolutions restent pertinentes selon la tâche et les contraintes du projet.
CNN et analyse de données : quel lien avec Excel ?
Excel est excellent pour organiser des données, explorer des résultats et créer des tableaux de bord. En revanche, entraîner un CNN directement dans une feuille de calcul n’est pas son rôle. Les modèles sont généralement développés avec des langages et des bibliothèques spécialisés, par exemple Python avec TensorFlow ou PyTorch.
Le flux de travail peut toutefois s’intégrer à des outils familiers. Un modèle analyse les images et exporte ses résultats dans un fichier CSV. Ce fichier peut ensuite être ouvert dans Excel pour filtrer les prédictions, calculer des indicateurs ou comparer les résultats par catégorie.
Par exemple, une équipe peut importer une liste contenant le nom de chaque image, la classe prédite et le niveau de confiance du modèle. Dans Excel, elle peut trier les prédictions les moins sûres pour organiser une vérification humaine, ou créer un tableau croisé dynamique pour comparer les défauts par ligne de production.
Cette complémentarité est souvent plus réaliste que de vouloir remplacer tous les outils existants. Le CNN prend en charge une tâche spécialisée ; Excel aide à rendre les résultats lisibles et exploitables par les équipes.
Les limites à anticiper
Un CNN n’est pas une solution magique. Il dépend fortement de la qualité et de la représentativité des données. Si les photos d’entraînement sont prises sous un éclairage précis, le modèle peut se tromper lorsque la lumière change. Si un défaut rare n’apparaît presque jamais dans les exemples, le réseau risque de mal le détecter.
Il faut également tenir compte du volume de données nécessaire. Des modèles complexes peuvent demander beaucoup d’exemples annotés, et l’annotation prend du temps. Une stratégie appelée apprentissage par transfert peut aider : on part d’un modèle déjà entraîné sur un grand ensemble d’images, puis on l’adapte à une tâche plus ciblée. Cela réduit souvent le besoin de repartir de zéro.
Enfin, les performances ne se résument pas à un score global. Pour une tâche de détection de fraude ou de défaut, la proportion de cas rares peut rendre l’exactitude trompeuse. Il faut examiner des mesures adaptées, comme la précision, le rappel et la matrice de confusion, puis décider quel type d’erreur est le plus acceptable.
La transparence compte aussi. Les CNN peuvent être difficiles à interpréter : ils fournissent souvent une prédiction sans expliquer clairement le raisonnement suivi. Des outils de visualisation peuvent indiquer quelles zones ont influencé la décision, mais ils ne transforment pas le modèle en système infaillible. La validation par des spécialistes reste importante, en particulier dans les domaines sensibles.
Comment démarrer un projet CNN sans se disperser
Avant de choisir une architecture ou d’écrire du code, définissez le problème. Voulez-vous classer des images, repérer un objet, segmenter une zone ou prévoir une valeur à partir d’un signal ? Une question bien cadrée évite de construire un modèle impressionnant sur le papier, mais inutile pour les besoins réels.
Voici une démarche simple pour structurer un premier projet :
- Définir le résultat attendu : préciser ce que le système doit prédire et comment sa réussite sera mesurée.
- Examiner les données : vérifier leur qualité, leur variété, leurs doublons et la fréquence des différentes catégories.
- Créer une référence : établir une méthode simple pour comparer les progrès du CNN.
- Séparer les jeux de données : organiser entraînement, validation et test avant d’ajuster le modèle.
- Tester les erreurs : examiner les cas mal classés, pas seulement le score final.
- Prévoir l’usage réel : décider qui vérifie les alertes, comment les résultats sont stockés et quand le modèle devra être réévalué.
Commencer petit est souvent le meilleur choix. Un jeu de données limité mais bien compris peut apprendre davantage qu’un immense dossier d’images mal étiquetées. Et si le projet se résume finalement à une règle simple ou à un tableau croisé dynamique, tant mieux : l’objectif n’est pas d’ajouter du deep learning partout, mais de choisir l’outil adapté.
À retenir pour vos projets d’analyse
Les CNN sont des réseaux de neurones conçus pour apprendre des motifs dans des données structurées, en particulier les images. Leurs couches de convolution détectent progressivement des caractéristiques simples puis plus complexes. Ils sont utilisés dans le contrôle qualité, la santé, l’analyse de documents, l’agriculture et bien d’autres domaines.
Pour obtenir des résultats utiles, il faut des données adaptées, une évaluation rigoureuse et une bonne compréhension des erreurs possibles. Dans un environnement de travail, le modèle peut s’intégrer à une chaîne plus large : Python pour l’entraînement, un export CSV pour les prédictions, puis Excel pour l’analyse et le suivi. Une bonne combinaison d’outils, sans demander à votre feuille de calcul de faire le travail d’un laboratoire d’intelligence artificielle.